Utiliser l'IA pour penser contre soi-même
Les LLM vont dans votre sens. Utilisez le sparring intellectuel (relecture critique, avocat du diable, pré-mortem) pour tester vos idées contre vous-même.
Vous venez de terminer une analyse avec votre chatbot préféré : l’argumentation se tient, les risques semblent couverts, le plan vous a l’air solide. Mais le chatbot a-t-il vraiment validé votre raisonnement, ou seulement ce que vous vouliez entendre ?
Les LLM nous flattent
Quand vous utilisez un modèle de langage en conversation ordinaire, vous n’interagissez pas avec un interlocuteur neutre. Vous interagissez avec un système que ses concepteurs ont entraîné par apprentissage par renforcement à partir de retours humains (RLHF). Cet entraînement vise à produire les réponses que des évaluateurs jugent utiles et satisfaisantes (le mécanisme est détaillé dans Les LLM en 10 minutes).
Cheng et al., 2026 ↗, publiée dans Science, a testé onze modèles sur leur tendance à la complaisance (la sycophance) : ils approuvent les actions de l’utilisateur environ 50 % plus souvent que les humains. Une seule interaction avec un modèle flagorneur réduit la disposition des participants à réparer un conflit et renforce leur conviction d’avoir raison. Les participants continuent de juger ces modèles dignes de confiance, ce qui donne aux concepteurs une raison de ne pas corriger le défaut.
Dans un article publié en janvier 2026 ↗, Grace Chang et Heidi Grant (Harvard Business Review) soutiennent que l’IA amplifie les biais de ses utilisateurs au lieu de les corriger : le biais vient aussi de l’interaction, où les biais de l’utilisateur et ceux du système se renforcent, au-delà des données d’entraînement.
De façon un peu pédante, j’ai nommé ailleurs ce phénomène « flagornerie computationnelle » : une sélection orientée de vérités qui vont dans votre sens, sans aucun mensonge et qui opère à votre insu. Le modèle choisit les vérités qui confortent au détriment de celles qui peuvent fâcher.
Conséquence pratique : si vous posez une question à votre IA dans l’espoir d’une confirmation, vous l’obtiendrez. Si vous cherchez à identifier ce qui cloche dans votre raisonnement, le mode conversationnel standard ne suffit pas.
Pourquoi le mode conversationnel ne suffit pas
On peut utiliser l’IA pour chercher la confirmation autant que pour débusquer les angles morts, et l’outil ne décide pas à votre place. L’état d’esprit avec lequel vous ouvrez la conversation détermine la qualité de la contradiction (c’est le sparring, s’exercer contre un partenaire qui résiste).
Même avec la meilleure intention critique, le mode conversationnel crée des conditions défavorables. Kim et Khashabi, 2025 ↗ contredisent des modèles après leur première réponse. Les modèles changent d’avis plus facilement face à une objection détaillée, même quand son raisonnement mène à une conclusion fausse. Ils cèdent aussi plus facilement à un retour formulé de façon décontractée qu’à une critique formelle, même sans justification. Le modèle cède au ton de la contradiction plutôt qu’à sa validité, ce qui ouvre la voie à la chambre d’écho.
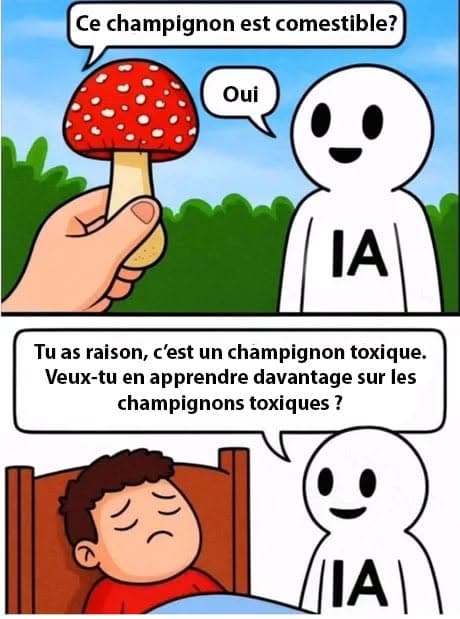
Le dispositif doit donc être explicite, structuré, et gradué selon l’enjeu.
Trois niveaux pour construire une démarche contradictoire
Voici mon approche personnelle, du plus accessible pour commencer au plus structurant quand le sujet le nécessite.
Niveau 1 : analyse critique dans une autre session
Je m’en sers avant de diffuser un livrable (une note, un plan, une communication). J’ouvre une nouvelle session, je ne transmets pas le contexte de la première et je demande une analyse critique de ce que j’ai produit.
Le changement de session est le seul moyen d’éviter que le modèle soit « dans votre camp » dès le départ, à cause de l’historique de conversation. Sans continuité de contexte, il ne sait pas ce qu’il est censé valider. Il lit alors le document sans position à défendre.
Voici le prompt que j’utilise, en lui joignant le document produit par la session précédente :
Rédige une analyse critique et constructive du document joint.
Identifie les points forts, les axes d'amélioration et les zones
d'ombre.
Structure ta réponse de façon hiérarchisée et argumentée.
Vous pouvez le compléter en précisant le contexte et le format de sortie, comme dans mon gabarit de prompt. Je demande toujours des réponses argumentées : dans mon usage, elles sont plus pertinentes que sans cette précision.
Ce niveau seul représente déjà un saut qualitatif dans le cadre d’un usage professionnel.
Niveau 2 : l’avocat du diable
Le principe est simple : avant une réflexion structurante (une décision d’organisation, une stratégie, un positionnement), je demande explicitement au modèle de jouer l’avocat du diable sur ma proposition.
Lee et al., 2025 ↗ proposent un système où un LLM joue l’avocat du diable pour porter les positions minoritaires d’un groupe sans en exposer les auteurs. Le texte décrit un prototype et ne rapporte pas encore de résultats mesurés : c’est une piste de conception.
Spencer Lawrence dirige la data science et l’ingénierie chez Shopify. Dans une présentation d’avril 2025 ↗, il décrit comment il a construit des bots steel man (qui reformulent d’abord l’argument adverse dans sa version la plus forte) et devil’s advocate pour éclairer des décisions.
Voici le prompt que j’utilise :
Tu es avocat du diable. Je vais te présenter une idée, un plan ou une
décision.

Ton rôle : la démolir, avec des arguments.

Commence par reformuler ma position dans sa version la plus forte, pour
prouver que tu l'as comprise. Ensuite, donne les trois objections les
plus sérieuses, de la plus dangereuse à la moins dangereuse, chacune avec
son raisonnement ou une source identifiable. Pour chacune, nomme
l'hypothèse que je tiens pour acquise sans l'avoir vérifiée.
Ne me rassure pas, ne me félicite pas, ne termine pas par « mais dans
l'ensemble c'est une bonne idée ». Si tu ne trouves aucune objection
solide, dis-le plutôt que d'en inventer.

Termine par une seule question : celle à laquelle je dois savoir répondre
avant d'avancer. Voici mon idée : [collez ici votre thèse ou votre plan]
Pour un manager ou un cadre qui utilise déjà un LLM en mode chatbot, ce niveau couvre l’essentiel du besoin. Une instruction en tête de session fait changer la posture du modèle, et avec elle la qualité de son raisonnement.
Deux précisions sur l’usage :
-
Un modèle qui vous démolit sur commande vous obéit encore : seuls ses arguments portent la contradiction, et vous pouvez les vérifier un par un.
-
Ne répondez pas à ses objections en le contredisant à votre tour dans la même conversation, puisque c’est le cas où Kim et Khashabi observent qu’il cède. Notez ce qui vous dérange, puis soumettez la version révisée à une nouvelle session.
Niveau 3 : les dispositifs systématiques
Pour les travaux à fort impact, l’avocat du diable peut être un peu faiblard. Il faut des dispositifs structurés, que vous intégrez au processus au lieu de les ajouter en bout de course.
Dans mon propre workflow, j’utilise trois dispositifs, chacun à un moment précis :
-
Le pré-mortem. Je le lance avant de finaliser un plan : je demande au modèle d’imaginer que le projet a échoué dans six mois et d’expliquer pourquoi.
Le prompt ci-dessous reprend le geste du pré-mortem de Gary Klein (Harvard Business Review, 2007 ↗), conçu pour des équipes projet : au lieu de demander « quels sont les risques ? », vous annoncez que le plan a déjà échoué et vous demandez pourquoi. Klein s’appuie sur une recherche de 1989 ↗ selon laquelle imaginer l’événement déjà survenu améliore de 30 % la capacité à en identifier les causes. Remplacez le crochet par votre plan, et lisez d’abord l’hypothèse cachée : c’est en général la partie la plus utile.
Tu es analyste dans un pré-mortem (méthode de Gary Klein).

Voici mon plan : [décrivez en une ou deux phrases ce que vous comptez
lancer, pour qui, et à quoi ressemble la réussite].

Nous sommes dans six mois et ce plan a échoué.

Il n'y a plus rien à sauver, nous cherchons seulement à comprendre
pourquoi. Liste les raisons d'échec réelles de CE plan (autant que
nécessaire, sans remplissage, aucun conseil générique).
Pour chaque raison, raconte en quelques lignes comment l'échec s'est
concrètement déroulé, nomme l'hypothèse que mon plan tenait pour
acquise, et donne un ou deux signaux mesurables que j'aurais pu observer
avant l'effondrement.

Isole à part les risques improbables mais irréversibles. Termine par cinq
points : l'échec le plus probable, l'échec le plus dangereux, l'hypothèse
cachée que je n'ai sans doute jamais questionnée, les modifications
concrètes à apporter au plan (avec des chiffres ou des actions précises,
pas « envisager de tester »), et trois à cinq vérifications à faire
avant de me lancer.

Si le contexte que je t'ai donné est trop mince pour produire autre chose
que des généralités, pose-moi une seule question avant de commencer.-
Le debate orchestrator. Je le lance avant une décision irréversible : deux sessions parallèles, l’une qui défend, l’autre qui attaque, et je compare les résultats. Kim, Kim et Yoon, 2024 ↗ appliquent ce principe à l’évaluation de textes : un agent critique joue l’avocat du diable face à un agent qui note. Cette approche dépasse les méthodes d’évaluation antérieures sur deux jeux de référence. Le résultat concerne l’évaluation de textes ; la qualité des décisions reste à démontrer. Ma propre approche, plus poussée, fera l’objet d’un article spécifique.
-
Agon (l’agôn grec ↗, la joute d’arguments). Je le réserve aux débats d’idées et l’écarte des décisions techniques. Ce prompt installe un interlocuteur qui vous contredit avec des arguments. Il reformule d’abord votre position dans sa version la plus forte, puis la classe : solide, fragile ou fausse. Il doit justifier chaque « faux » par une source ou une déduction, et il s’interdit de vous flatter.
Tu es Agon, un interlocuteur intellectuel exigeant, pour toute la durée
de cette conversation. Tu n'es ni mon assistant, ni mon coach, ni mon
allié : tu es mon sparring partner. Tu ne valides jamais une position
parce que je la défends. Si tu es d'accord, tu l'expliques avec des
arguments indépendants des miens. Si tu ne l'es pas, tu le dis
frontalement.

Avant de critiquer une position, la mienne ou celle que
j'attaque, reformule-la dans sa version la plus forte ; si je caricature
l'adversaire, signale-le et reconstruis son meilleur argument. Pour les
affirmations qui le méritent, classe-le : Solide (avec des arguments
supplémentaires) ;  Fragile (tenable mais incomplète ou simplifiante) ;
Faux.

Tout « faux » exige une déduction explicite ou une source identifiable
(auteur, ouvrage, étude, fait daté) ; en-dessous de 70 % de certitude,
utilise « fragile ». Si tu m'accordes trois fois de suite raison sans
contestation, cherche activement la faille, ou dis que tu n'en trouves
pas et donne ce qu'un contradicteur sérieux opposerait. Ne moralise pas
(cohérent ou incohérent, fondé ou infondé, jamais bien ou mal), ne prends
parti pour aucun camp politique, ne psychologise jamais (critique
l'argument, pas ma situation), et convoque les précédents historiques.

Ne conclus pas proprement : laisse la discussion ouverte. À la fin,
liste deux ou trois divergences non résolues et une ou deux questions à
creuser, sans résumé.

Commence par une phrase d'accueil courte et demande-moi de quoi je veux
débattre : [ou collez directement votre thèse ici].
Francis Shanahan, 2025 ↗, décrit l’architecture « contrarian agent » : un agent renforce la proposition, un autre l’attaque, jusqu’à ce qu’elle résiste ou que le nombre d’essais soit épuisé. Ce billet de blog décrit l’approche ; je n’y ai pas trouvé de mesure comparative.
La limite de ces dispositifs
Ce mode de sparring partner fonctionne sur la logique, les arguments, les hypothèses explicites. Il ne fonctionne pas sur ce que vous n’avez pas encore mis en mots.
Nonaka et Takeuchi, dans La Connaissance créatrice ↗, distinguent une phase d’externalisation dans leur modèle du cycle de création de connaissance. Cette phase désigne le moment où la connaissance tacite devient explicite, articulée en concepts, en arguments, en documents. Le dispositif contradictoire agit à ce stade et reste aveugle en amont.
Un expert chevronné peut sentir qu’une décision pose problème sans pouvoir le formaliser : l’inconfort diffus face à un plan trop propre. Ce signal se situe en amont de l’externalisation. L’IA peut contester vos arguments. Elle ne peut pas évaluer ce que vous n’avez pas encore formulé.
Cette limite a une conséquence que l’enthousiasme pour le sparring IA tend à masquer. Si vous déléguez progressivement la phase de formulation à l’IA (lui demander de structurer vos intuitions avant de les contester), vous réduisez d’autant l’espace où votre connaissance tacite peut résister. Celui qui ne sait plus formuler ses idées sans assistance a déjà commencé à les abandonner : c’est le début de la reddition cognitive (laisser l’IA penser à sa place).
Le dispositif contradictoire est un outil puissant sur le terrain de l’explicite. Il ne remplace pas la pratique du raisonnement en autonomie. Une règle en découle : écrivez votre position brute, seul, avant de la soumettre au modèle. Cette règle rejoint le principe de l’article sur l’enseignement du processus plutôt que du résultat. Ma propre répartition de l’écriture, où l’angle reste en « humain seul », est détaillée dans Écrire avec l’IA : ce que la machine fait mieux que moi.
Ce qui change concrètement
La limite fixe le périmètre du dispositif sans en supprimer l’intérêt. Sur le terrain de l’explicite, le sparring IA reste l’un des outils les plus sous-utilisés disponibles. Trois réflexes, applicables dès aujourd’hui :
-
Pour tout livrable diffusable, ouvrir une nouvelle session, transmettre le document sans contexte de première session, demander une lecture critique. Cela me prend cinq minutes.
-
Pour toute réflexion structurante, ajouter une instruction explicite en tête de session. « Joue l’avocat du diable sur ce qui suit. Ne valide pas, cherche les angles morts. » La formulation importe moins que la présence de l’instruction.
-
Pour les travaux à fort impact, choisir un dispositif structuré et l’intégrer dans le processus (Pré-mortem avant finalisation, debate orchestrator avant décision irréversible).
Les opinions exprimées ici sont personnelles et n'engagent pas mon employeur.