Faites débattre une IA avec elle-même pour améliorer vos décisions
Un prompt de débat multi-personae IA à coller : un panel d’experts, un facilitateur, un cas joué, ses limites et les cas où l’utiliser.
Le 6 septembre, j’écrivais, à propos d’un large modèle de langage (LLM) : « Arrêtez de donner un rôle à votre LLM : ça ne sert plus à rien, et ça le distrait. » Voici un cas où je lui en donne plusieurs.
Un prompt à coller pour faire débattre un panel d’experts
Ce prompt prolonge l’article précédent, Utilisez l’IA pour penser contre vous-même !, qui proposait trois niveaux pour penser contre soi avec une IA : relire le livrable dans une nouvelle session, mobiliser l’avocat du diable, monter des dispositifs systématiques. Il relève du troisième. À coller dans une session neuve de votre assistant, après avoir écrit votre propre position, seul : le panel part de ce que vous avez formulé.
Tu vas conduire un débat structuré entre plusieurs experts simulés, puis
me rendre le résultat.

Sujet : [une question de jugement, pas une question de fait]
Contexte : [la situation, sans ma position ; tout ce qui n'est pas
établi est marqué comme hypothèse]
Objectif : [ce que je veux en sortie, par exemple les 3 priorités à
trancher ou à tester, avec les divergences maintenues]
Nombre d'experts : [6 à 8]

1. Compose le panel toi-même, sans me demander de le choisir. Chaque
expert a un nom, un métier, un modèle mental, deux biais cognitifs et
deux valeurs, en tension avec celles d'un autre expert. Contraintes : au
moins trois modèles mentaux distincts parmi incrémental, disruptif,
pragmatique, analytique, sceptique, systémique, éthique ; au moins trois
paires de biais opposés (par exemple optimisme et pessimisme, statu quo
et goût de la nouveauté) ; au moins trois tensions de valeurs (par
exemple rapidité contre rigueur). Chaque expert défend la meilleure
version de sa position. Ajoute deux rôles sans position : un
facilitateur et un avocat du diable. Affiche le panel avant de débattre.
S'il ne respecte pas les contraintes, corrige-le une seule fois.

2. Joue le débat en quatre temps, sans résumer les échanges.
- État indésirable : chaque expert décrit le problème selon son modèle
mental, en 2 à 3 phrases.
- Causes : trois à cinq causes. Pour chacune, les experts s'opposent.
- Actions : chaque expert propose deux ou trois actions (verbe, objet,
délai), puis le panel converge vers cinq.
- État désiré : le panel formule un état désiré observable et mesurable,
et retient trois priorités.

3. Les experts parlent sur le mode exploratoire : ils posent des
questions critiques, contestent en reconnaissant ce qui tient,
reformulent, signalent les contradictions. Sont interdits « je suis
d'accord, j'ajoute » et « vous avez tort ».
Le facilitateur n'a pas d'opinion. Il relève les contradictions non
explorées, demande des preuves, reformule les désaccords et conduit le
débat vers les priorités.
L'avocat du diable attaque ce que le panel produit, jamais le sujet. Il
conteste chaque conclusion avant qu'elle remonte, cherche l'argument que
personne ne porte, signale les accords obtenus sans confrontation réelle.
Il ne propose aucune alternative.

4. À la fin, chaque expert écrit quatre rubriques et prend position :
hypothèses ; confiance (haute, moyenne ou basse, et pourquoi) ; ce qui
me ferait changer d'avis ; désaccords avec les autres experts, nommément.

5. Rends les trois priorités avec le soutien de chacune dans le panel,
les divergences maintenues et l'état désiré. Ne force pas le consensus :
un désaccord non résolu se documente.
Le prompt comporte trois champs à remplir. Le sujet est une question de jugement : un fait se cherche dans des sources, il ne se débat pas. Le contexte reste neutre, sans votre position, et tout ce qui n’est pas établi y figure comme hypothèse. L’objectif dit ce que vous voulez en sortie. Voici ceux du cas joué plus bas, tels que transmis au skill (une instruction réutilisable pour Claude Code) :
Sujet : Un consultant doit-il facturer au résultat plutôt qu'au temps
passé quand l'IA divise par trois le temps de livraison ?

Contexte : Cas fictif, utilisé pour documenter le fonctionnement du skill.
Un cabinet de conseil en transformation digitale facture ses missions au
temps passé (taux journalier). Hypothèse posée, non démontrée : l'IA
générative réduit fortement le temps nécessaire pour produire les mêmes
livrables (ordre de grandeur supposé : divisé par trois). Des clients
commencent à demander pourquoi ils paieraient le même nombre de jours.

Objectif : Obtenir les 3 priorités à trancher ou à tester avant de changer
(ou non) de mode de facturation, avec les divergences maintenues.

Nombre de personae : 6 à 8 (nombre par défaut du skill).
Cette version condensée est dérivée du skill debate-orchestrator, que j’ai écrit. Le cas joué plus bas a été produit par le skill complet (version 1.0.0), pas par ce prompt. Le noyau du skill (version 1.1.0, avec ses trois prompts : composition du panel, exécution du débat, orchestration) est disponible dans le dépôt GitHub claude-skills ↗ et en archive zip. C’est une façon pour moi d’introduire deux autres techniques de prompt avancées, le panel d’experts et le town hall debate, encapsulées dans un seul outil.
La technique : un panel d’experts composé à la volée + un town hall avec un facilitateur
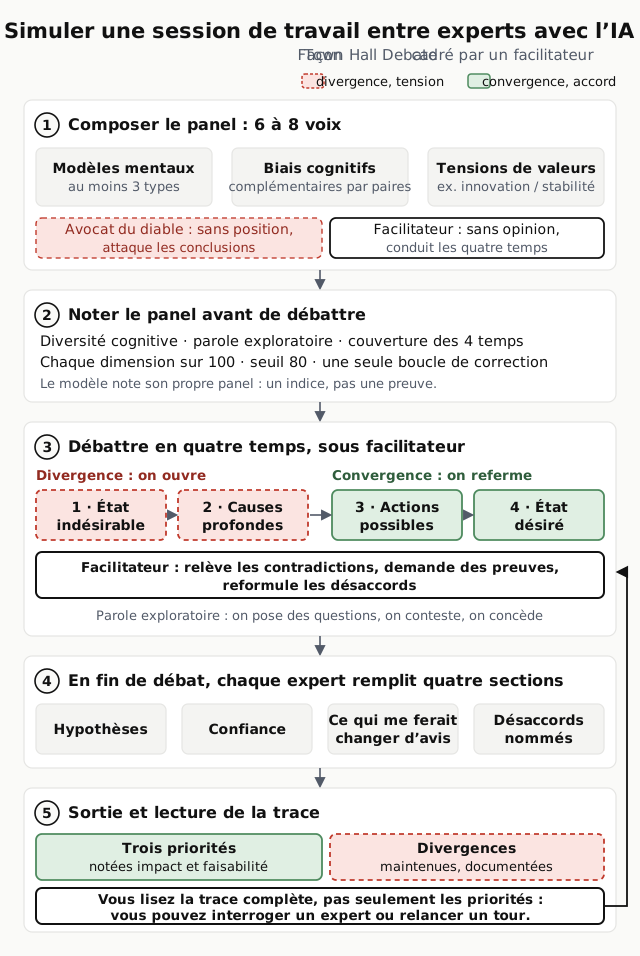
Le skill se lance depuis une session de Claude Code. Il compose un panel d’experts, joue un town hall (une assemblée où des participants d’horizons différents débattent d’une question devant un animateur), puis rend des priorités et les désaccords maintenus. Tout se passe dans une seule session. Le schéma ci-dessous résume ses cinq étapes ; le prompt ci-dessus les reprend toutes, sauf la notation chiffrée du panel.
Cette technique répond à deux limites écrites dans l’article précédent.
-
Le contradicteur sur commande vous obéit encore. Vous lui ordonnez la critique, il la produit, et vous pouvez vérifier ses arguments un par un, mais il reste une seule voix. Pour les travaux à fort impact, je jugeais l’avocat du diable « un peu faiblard ».
-
Le sparring (s’exercer contre un partenaire qui résiste) ne couvre que ce que vous avez déjà mis en mots. Une intuition que vous ne savez pas encore formuler reste hors de portée du contradicteur, aussi féroce soit-il.
Le skill vise la première limite : plusieurs voix qui se contredisent entre elles, plutôt qu’une seule qui obéit. Il ne touche que partiellement à la seconde : le panel part d’une formulation explicite, donc la règle de l’article précédent reste entière.
Un panel d’experts composé à la volée
Le principe vient de Hybrid Intelligence ↗, le livre de Kevin Holt sur l’intelligence hybride (Routledge, 2025). Holt s’appuie sur Scott Page pour défendre une diversité de fond, celle des façons de raisonner, plutôt qu’une diversité de surface, celle des profils (pp. 74-77). Il ajoute une condition : la diversité ne sert que si les membres du groupe contribuent réellement au débat (p. 88).
Le skill traduit ce principe en intégrant trois dimensions dans la composition de son panel (ce sont des choix de conception et ne figurent pas dans le livre) :
-
des modèles mentaux d’au moins trois types,
-
des biais cognitifs complémentaires par paires,
-
des tensions de valeurs (voir le prompt ci-dessus).
Dans le cas joué plus bas, l’exécution compte sept modèles mentaux, et l’optimisme du directeur de mission fait face à la tendance de la juriste à surestimer la probabilité de litige.
Le skill vise six à huit voix. Ni Holt ni Town Hall Debate Prompting (Sandwar et al., 2025 ↗) n’établissent ce nombre. Ce second travail découpe un seul modèle en personnages simulés, ou personae, et les fait voter. Il en a testé de deux à quinze, avec cinq et sept comme meilleurs résultats selon la tâche (p. 4).
Cela nuance ce que j’ai écrit le 6 septembre sur l’inopportunité de donner des rôles aux prompts (cette règle reste valide et nous avons affaire ici à des exceptions). Aussi mes prompts de l’article précédent donnent un rôle chacun (avocat du diable, Agon, mon prompt de débat d’idées) ; ici, il y a plusieurs rôles et ils s’opposent entre eux. Dans un prompt isolé, un rôle n’a rien à quoi s’opposer et l’utiliser est contre-productif avec les modèles les plus récents parce qu’il oriente alors les réponses. Dans un débat, il fournit des paradigmes qui s’opposent entre eux.
Avant de débattre, le skill complet note sur 100 son propre panel sur trois dimensions (la diversité cognitive, le potentiel de parole exploratoire, la couverture des quatre temps du débat) et recommence l’opération en cas de note inférieure à 80.
Reste à savoir si ces paradigmes s’opposent vraiment quand un seul modèle les joue. J’y reviens plus bas.
Un town hall avec facilitateur
Le skill déroule un tour de débat en quatre temps, ceux du prompt ci-dessus. Les deux premiers temps ouvrent l’éventail, les deux derniers le referment. Les experts y parlent sur le mode exploratoire : on pose des questions, on conteste, on concède.
Un facilitateur sans opinion conduit l’ensemble. Holt lui confie la conscience métacognitive du groupe (p. 96). Le facilitateur fait avancer le débat vers des priorités ; la collecte d’oppositions revient à l’avocat du diable. En fin de débat, chaque expert remplit quatre sections imposées : hypothèses, niveau de confiance, ce qui le ferait changer d’avis, désaccords nommés.
Exemple d’un cas joué : « faut-il facturer au résultat ? »
Pour voir ces leviers à l’œuvre, j’ai lancé le skill complet, et non le prompt ci-dessus, sur un cas fictif : un cabinet de conseil facture ses missions au temps passé, et l’on suppose, sans le démontrer, que l’IA divise par trois le temps de livraison. Faut-il facturer au résultat ? Il a composé, seul, un panel de sept voix :
-
une associée gérante,
-
un directeur de mission référent IA,
-
une directrice des achats côté client,
-
un contrôleur de gestion,
-
une juriste en droit des contrats,
-
un directeur des systèmes d’information (DSI) client,
-
une sociologue du travail.
On retrouve aussi notre fameux avocat du diable, qui attaque ce que les autres produisent. Ces voix sont des positions composées pour s’opposer, sans rapport avec les jumeaux cognitifs (des modèles de la façon de penser d’une personne réelle). J’étais un peu surpris que le panel ne comptât aucun consultant junior : ils n’entrent dans le débat que par la voix de la sociologue. Je traite leur nouvelle place, côté équipes de codeurs, dans Si l’IA fait le travail des juniors, par où entre-t-on dans le métier ?.
Voici ce qu’on observe :
-
Le mouvement le plus déterminant du facilitateur tient en une reformulation. En effet, le directeur de mission proposait d’être payé sur un livrable accepté ; la juriste lui répondait que cela s’appelle un forfait (ce que le directeur de mission savait déjà), et que le cabinet sait déjà en vendre. Le facilitateur a alors écrit que « le mot “résultat” recouvre au moins trois choses dans ce débat » : un livrable accepté, un indicateur opérationnel, un effet business. Le DSI achète volontiers le premier, accepte le deuxième si ses propres engagements sont écrits au contrat, refuse de payer le troisième de façon variable. L’acheteuse ne demandait que le premier : ne pas payer des jours non réalisés. Cette reformulation a déplacé la question, de « faut-il facturer au résultat ? » vers « de quel résultat parle-t-on, offre par offre ? ». Le résultat reste pragmatique.
-
Une demande de preuve avait joué le même rôle plus tôt. Le directeur de mission affirmait que des confrères facturent déjà des jours que l’IA a absorbés. Le facilitateur lui a demandé s’il parlait de cas observés ou d’une inférence, et l’affirmation est devenue une inférence sans cas documenté.
-
L’avocat du diable, lui, a relevé dès la première étape que la synthèse du facilitateur prêtait à l’associée un accord qu’elle n’avait pas exprimé : « Ce consensus est attribué, pas exprimé. » Le facilitateur a corrigé. Plus loin, l’avocat du diable a nommé un argument que personne ne portait : un cabinet qui refuse toute exposition au résultat business signale qu’il ne croit pas à l’effet de son propre travail. Le directeur de mission l’a repris. Le DSI a concédé que le signal compte, et maintenu que le variable aurait tendance à pousser le consultant à choisir un indicateur facile à mesurer et à atteindre. Le débat ne dit rien du client ; d’expérience, s’il y a des success fees (honoraires de succès), il est à même de les identifier ou de les valider. Dans ses quatre sections finales, le directeur de mission écrit que le forfait ne se justifie plus si le gain net, mesuré sur les livrables validés, tombe sous un tiers du temps habituellement facturé. C’est un critère testable, avec un seuil que le personnage invente, comme tout le reste du cas.
J’ai observé que la sortie ne répond pas directement à la question posée (dommage, ça aurait fait un très beau post LinkedIn sur la fin du taux journalier moyen (TJM) dans le conseil). Mais elle propose une approche cohérente. Mon prompt demandait des priorités « à trancher ou à tester », et le modèle a converti « faut-il facturer au résultat ? » en trois préconditions :
-
mesurer le gain réel par type d’activité avant de toucher aux prix,
-
définir ce que « résultat » veut dire offre par offre,
-
trancher qui capte le gain de productivité et comment le client le sait.
Les sept votants approuvent la première, l’acheteuse y mettant une condition. L’avocat du diable en donne la raison : « l’action 1 fait consensus parce qu’elle repousse toutes les décisions. » L’acheteuse accepte d’attendre la mesure si le cabinet s’engage à appliquer ensuite la règle de partage aux missions en cours. L’associée refuse de s’engager sur une règle qu’elle ne connaît pas. Le facilitateur note le désaccord et le maintient. Cinq désaccords restent ouverts. Le dernier, soulevé par l’avocat du diable, met en doute le cadrage : les clients demandent peut-être une baisse de prix, quel que soit le mode de facturation.
Télécharger l’intégralité du débat en PDF (18 pages) : panel, scores, quatre étapes et divergences. Tous les personnages, montants et situations y sont inventés.
Reste à savoir ce que vaut un consensus produit par le même modèle.
Un panel joué par un seul modèle diversifie-t-il vraiment et suffisamment les points de vue ?
La question se pose d’abord à notre exemple, puis à la recherche.
Ce que l’exemple ne montre pas
Un seul modèle a écrit toutes les répliques, y compris celles de l’avocat du diable qui a corrigé le facilitateur. Dans cette exécution, les corrections sont venues du modèle lui-même. Or le skill connaît ce risque : il demande à chaque expert de défendre sa meilleure position, et il range la convergence d’un panel parmi les signaux à traiter comme une hypothèse à valider.
À noter que cette lecture a aussi un coût. Le compte rendu fait 18 pages. Le skill a mis environ 5 minutes à tourner et consommé environ 600 000 tokens (ce qui est indolore pour mon forfait).
Ce que la recherche dit de l’approche mono-modèle
Ma revue de littérature ne trouve aucune mesure de l’effet d’un panel mono-modèle doté d’une méthode et d’un facilitateur sur une décision. Le travail le plus proche, Town Hall Debate Prompting, rapporte des gains face à la chaîne de pensée sur des tâches de raisonnement logique (13 % de précision par cellule en plus avec GPT-4o). Les autres sources marquent des réserves sur une approche mono-modèle pour un débat d’experts sans stratégie de réflexion. C’est bien ce point que je contourne avec l’intégration d’un rôle de facilitation. D’expérience, je trouve également que notre avocat du diable contribue à recadrer les débats quand les réponses des personae sont en-deçà ou à côté de la plaque. Voici donc ce que dit ma revue de littérature :
-
Premier doute : un seul modèle derrière toutes les voix. Zhu et al., 2026 ↗ relèvent que le débat standard entre agents sous-performe souvent un simple vote majoritaire. Sous agents homogènes et mises à jour de croyance uniformes (chaque agent révise son avis de la même façon), il ne peut pas améliorer le résultat de façon fiable. Ils nomment deux mécanismes absents du débat standard : la diversité des points de vue de départ et la communication explicite d’une confiance calibrée. Mon panel est un seul modèle derrière toutes les voix, et l’écart entre sept voix et une voix qui change de costume n’est pas démontré.
-
Deuxième doute : le facilitateur. Je n’ai trouvé aucune mesure de son effet. Le modérateur de Tree-of-Debate arbitre deux articles scientifiques (Kargupta et al., 2025 ↗), sur un seul modèle. Les experts qui ont construit les paires évaluent le résultat. Une ablation (le retrait d’un composant pour en mesurer l’effet) montre toutefois que la structure compte. Town Hall Debate Prompting n’a ni facilitateur ni modérateur. Reste la menace inverse. Yao et al., 2025 ↗ montrent que la sycophance, la complaisance d’un modèle envers son interlocuteur que j’ai nommée pompeusement « flagornerie computationnelle », fait descendre l’exactitude du débat sous celle d’un agent seul.
L’objection d’homogénéité reste donc scientifiquement valide. Elle suppose pourtant que vous receviez un verdict. Ici, vous recevez une simulation de débat, et vous pouvez y intervenir. J’ai laissé tourner le skill de bout en bout sans y toucher, parce que je trouvais opportun de présenter un exemple. Dans un cas réel, vous devenez l’interlocuteur du débat : vous interrogez un expert, relancez un tour, poussez une piste. Le garde-fou, c’est vous, et le panel ne vous remplace pas.
Quand utiliser ce skill
Le skill pose lui-même trois conditions, il faut :
-
au moins trois perspectives en conflit, donc un problème à plusieurs dimensions ;
-
une question de jugement et non de fait, car un fait se cherche dans des sources et non dans ce type d’approche ;
-
du temps, puisque le skill écarte les décisions à prendre en moins d’une heure.
J’ajoute une condition : connaître assez le sujet pour comprendre les débats des personae. Sentir qu’un dialogue est riche, qu’un facilitateur fait avancer ou qu’une acheteuse simulée dit une énormité demande de connaître le terrain. Ce jugement s’exerce sur la trace : trois priorités livrées seules le court-circuitent. Si vous débutez sur le sujet, ce contrôle vous échappe : vous lirez un texte fluide sans pouvoir le juger. En dehors de votre domaine d’expertise, les niveaux 1 et 2 de l’article précédent coûtent moins cher et se vérifient argument par argument. Pour un débat d’idées plutôt qu’une décision, je garde Agon, présenté dans l’article précédent.
Ce que j’en retiens
Le town hall debate vaut par ce qu’il laisse voir avant le consensus. Les échanges intermédiaires m’apprennent plus, en général, que les trois priorités résumées en fin d’échange, qui sont la partie la moins sûre du résultat. Je ne lui demande donc pas de décider : je lui demande de montrer où les paradigmes se heurtent, et je juge. J’aime beaucoup utiliser ce skill quand j’ai fini de développer les fonctionnalités d’un prototype pour simuler une revue produit et imaginer la suite.
Les opinions exprimées ici sont personnelles et n'engagent pas mon employeur.